概述
掩膜要能用来算出点什么,才算有价值
语义分割就是把图像里的每个像素归到一个类别:道路、建筑、植被、天空、缺陷、组织、作物。真正让它值得做的是下一步。掩膜本身只是一张图,交付物是由它算出来的那张表——这张图里植被占多少、这处缺陷有多少毫米、这片地里某种作物有多少公顷、两个时期之间这些数字又变了多少。
我们的定位是成熟模型推理代跑,不是模型研发。我们选择类别体系与客户需求相符的公开成熟权重或客户提供的现有权重,统一整理输入文件,批量推理、后处理并打包结果;服务不包括重新标注训练集、从零训练模型,也不通过微调增加原模型不支持的新类别。
这个边界非常重要:Cityscapes 模型不会因为同样叫「语义分割」就自动变成裂缝检测模型。全量处理前,我们会先用代表性样本检查领域匹配、分辨率、类别覆盖与输出质量。如果没有成熟权重能可靠覆盖客户要的类别,我们会直接说明,而不会把一个训练项目藏进代跑报价里。
四类服务范围
每个领域用什么模型,跑出来是什么样
四个领域除了流程形状相似,其余几乎没有共同点。每个领域都一次讲完再进入下一个:能用哪些成熟权重、适合哪些任务、真实输出长什么样、这些权重在官方基准上跑到多少分,以及这些分数是在什么类别体系上测出来的。数据集名称描述的是权重原本就认得的类别,不是每个项目要重新训练的数据。
街景语义分割
可用模型
SegFormer、DeepLabv3+、Mask2Former、OneFormer、HRNet、BiSeNet 与 PP-LiteSeg 等成熟权重。根据任务在精度、小目标边界与吞吐量之间选择;如果结果既要面积又要数量,则选择支持语义、实例或全景分割的现有模型。
数据集与类别体系
Cityscapes(19 类道路场景)、Mapillary Vistas(66 类多地区街景)、ADE20K(150 类场景解析)、BDD100K 与 IDD。最终能输出什么,取决于所选权重原生支持的标签;项目中不会临时增加新类别。
适用范围
谷歌或百度街景帧、360 全景、Mapillary 或 KartaView 影像、行车记录仪视频与固定朝向照片。可计算绿视率、天空可见比例、道路与人行道占比、沿街界面构成、车辆/行人像素及路网级汇总指标。
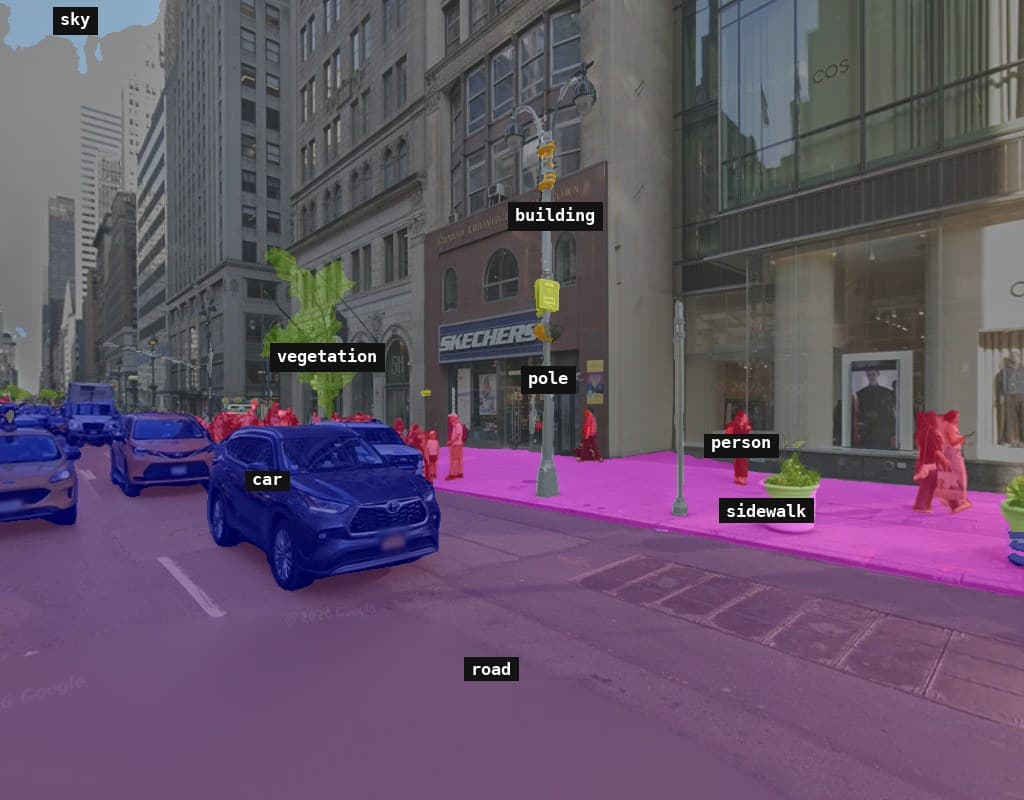
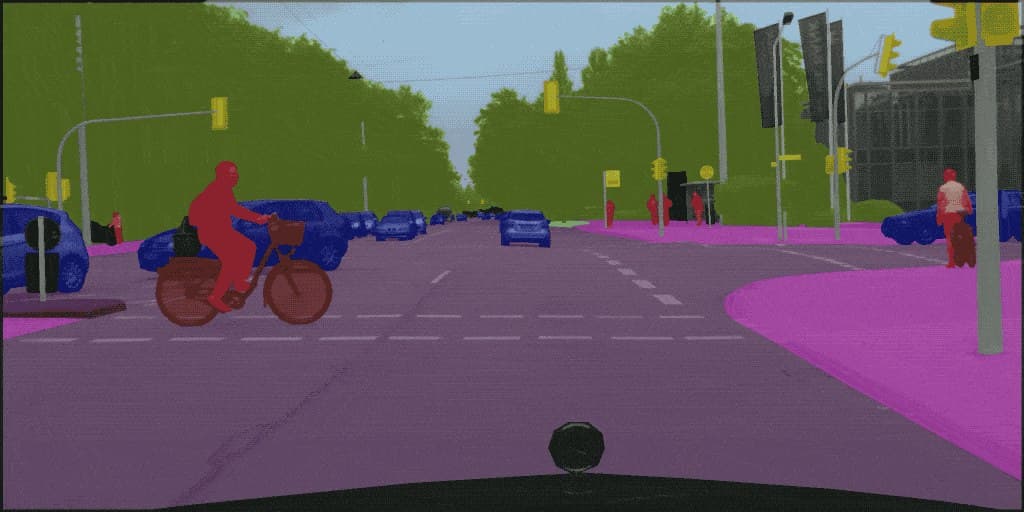
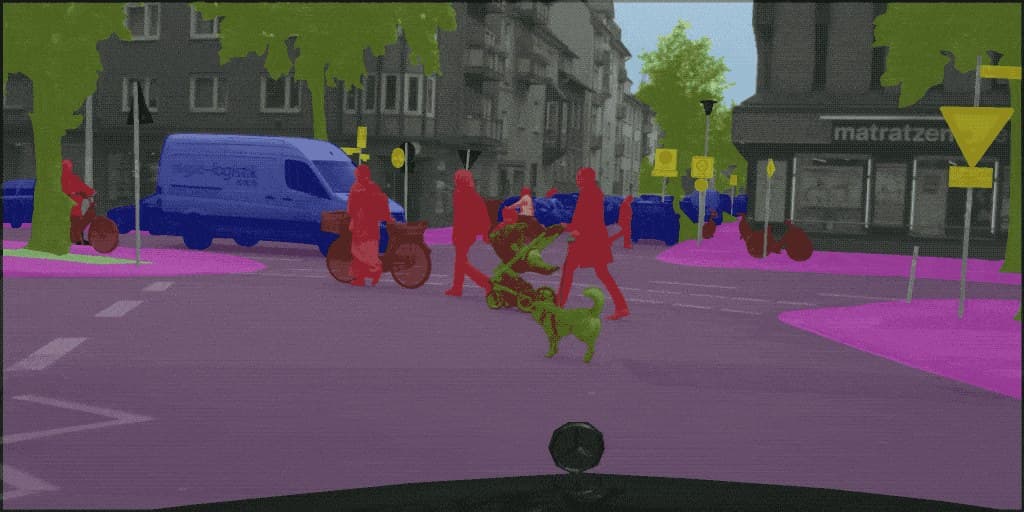
输出示例 · 街景与行车视角
在 Cityscapes 类别体系下分出道路、人行道、建筑、植被、天空、车辆与行人。绿视率、天空可见比例、沿街界面构成与出行指标,都是从这一层输出上算出来的。
公开精度指标与类别体系
Cityscapes 是 19 类道路场景的参考基准;ADE20K 是更宽的 150 类场景解析集,当项目需要街道设施、雨棚、招牌或建筑立面细部这些 Cityscapes 词表里没有的东西时才会用到。同一套模型在 ADE20K 上的分数会低很多——不是模型退化了,而是 150 类本身就比 19 类难得多。
Cityscapes 验证集 · mIoU
- SegFormer-B51024² · NeurIPS'2184.0
- OneFormerSwin-L · s.s.83.0
- Mask2FormerSwin-L · s.s.82.9
- HRNetV2-W481024×204881.1
- DeepLabv3+Xception-6578.8
- PP-LiteSeg-B2STDC2 · 102.6 FPS78.2
- SegFormer-B03.8M · 15.2 FPS76.2
- BiSeNetV2512×1024 · 156 FPS73.4
ADE20K 验证集 · mIoU
- OneFormerSwin-L · s.s.57.0
- Mask2FormerSwin-L · s.s.56.1
- UPerNet + Swin-Ls.s. · ms+flip 53.552.1
- SegFormer-B5640²51.8
- SegFormer-B03.8M params37.4
| 数据集 | 类别数 | 类别构成 |
|---|---|---|
| Cityscapes | 19 | 官方归为 7 组:地面(道路、人行道);建筑(建筑、围墙、栅栏);杆件与标志(杆、交通灯、交通标志);自然(植被、地形);天空;人(行人、骑行者);车辆(小汽车、卡车、公交、火车、摩托车、自行车)。 |
| Mapillary Vistas | 66(v1.2)· 124(v2.0) | 顶层七大组:动物、建构筑物、人、路面标线、自然、物体、空类。补上了 Cityscapes 没有标签的街道细部——车道线、路缘、井盖、长椅、垃圾桶、路灯,影像来自六大洲。 |
| ADE20K | 150 | 室内外通用的场景解析体系:背景类(墙、天空、地面、道路、水体、山体、草地)与物体类(车、人、树、招牌、雨棚、台阶、栏杆、路灯)混合。 |
| BDD100K | 19 | 语义分割标签与 Cityscapes 19 类对齐;影像是美国行车记录仪素材,天气、时段与道路类型的分布宽得多。 |
| IDD | 26(常用层级) | 四级标签体系,可按 7/16/26 类读取;补充了机动三轮车、路障、广告牌、非硬化可行驶路肩等南亚道路要素。 |
| COCO-Stuff | 171 | 80 类物体加 91 类背景——影像是一般摄影而非道路场景时用它。 |
遥感语义分割
可用模型
U-Net / U-Net++、DeepLabv3+、SegFormer、UPerNet + Swin / ConvNeXt、HRNet,以及 GeoSeg 中的成熟权重。大幅栅格会重叠切片、批量推理、边缘融合并重新拼接,同时保留地理参考。
数据集与类别体系
LoveDA 适合城乡土地覆盖;ISPRS Potsdam / Vaihingen 覆盖不透水面、建筑、低矮植被、树木与车辆;DeepGlobe、DynamicEarthNet 用于地表覆盖;SpaceNet 用于建筑与道路。传感器、地面分辨率和波段配置必须与权重相匹配。
适用范围
卫星、航空与无人机正射影像,可用于土地覆盖面积、建筑轮廓、道路提取、植被或树冠覆盖、不透水面、地块汇总与跨期变化。结果既可保留为栅格,也可矢量化为 GIS 多边形或线。
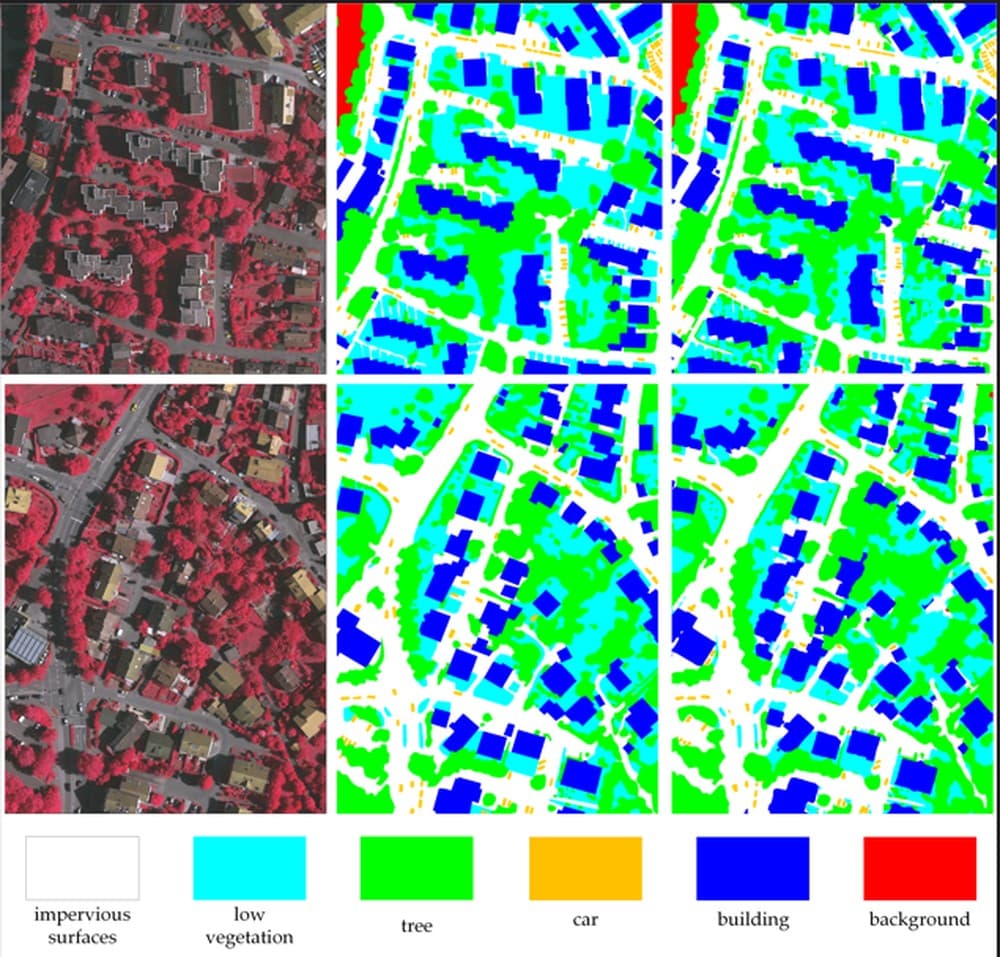
输出示例 · 航空与卫星影像
从带地理参考的影像切片中提取地表覆盖类别,再拼回成无缝掩膜。面积、建筑轮廓与植被覆盖率按地块或按期次从这张掩膜上统计。
公开精度指标与类别体系
地表覆盖的分数远低于街景,这是正常的:在 0.3 m 地面分辨率下,裸地与森林这类界线本身就模糊,而 LoveDA 还刻意把城市域和乡村域混在一起考迁移能力。当影像与基准高度接近时——比如 5–9 cm 的 ISPRS 航空正射影像——同样的架构能到 80 分中段。
LoveDA 测试集 · mIoU
- UNetFormerResNet-18 · GeoSeg52.4
- HRNetW3249.8
- FactSegResNet-5048.9
- PSPNetResNet-5048.3
- UNet++ResNet-5048.2
- UNetResNet-5047.8
- DeepLabv3+ResNet-5047.6
- FCN-8sVGG-1646.7
ISPRS Potsdam / Vaihingen · mIoU
- FT-UNetFormer · PotsdamSwin-B87.5
- UNetFormer · PotsdamResNet-1886.5
- FT-UNetFormer · VaihingenSwin-B84.0
- UNetFormer · VaihingenResNet-1882.5
| 数据集 | 类别数 | 类别构成 |
|---|---|---|
| LoveDA | 7 | 背景、建筑、道路、水体、裸地、森林、农田。0.3 m 分辨率,覆盖三座城市,分为城市域与乡村域两个子集。 |
| ISPRS Potsdam / Vaihingen | 6 | 不透水面、建筑、低矮植被、树木、车辆、杂类背景。真正射影像,分辨率分别为 5 cm 与 9 cm,并附带数字表面模型。 |
| DeepGlobe Land Cover | 7 | 城市、农田、牧场、森林、水体、裸地、未知——0.5 m 卫星影像,面向国土尺度制图。 |
| DynamicEarthNet | 7 | 不透水面、农田、林地与其他植被、湿地、裸土、水体、冰雪——日频时序数据,为变化检测而不是单期制图设计。 |
| SpaceNet | 建筑 / 道路 | 建筑轮廓多边形与道路中心线网络,按城市分卷发布;目标产物是矢量图层,而不是地表覆盖栅格。 |
| UAVid | 8 | 建筑、道路、静止车辆、移动车辆、树木、低矮植被、人、背景杂类——无人机倾斜视频,视角更接近街景而非正射。 |
医疗影像分割
可用模型
nnU-Net 任务权重、U-Net 系列、面向三维数据的 UNETR 与 Swin UNETR,以及用于提示式掩膜的 MedSAM / SAM-Med2D。处理时保留像素间距、方向与切片顺序,可交付逐层掩膜或重建后的三维体积。
数据集与目标区域
Medical Segmentation Decathlon 与 BTCV 的多器官 CT,BraTS 的脑肿瘤,KiTS 的肾脏与肾肿瘤,LiTS 的肝脏与肿瘤,以及其他已有公开权重的器官任务。只把权重用于其支持的模态、解剖部位与采集范围。
适用范围与边界
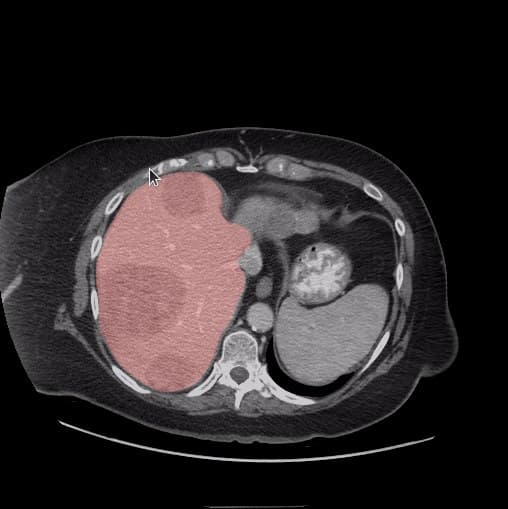
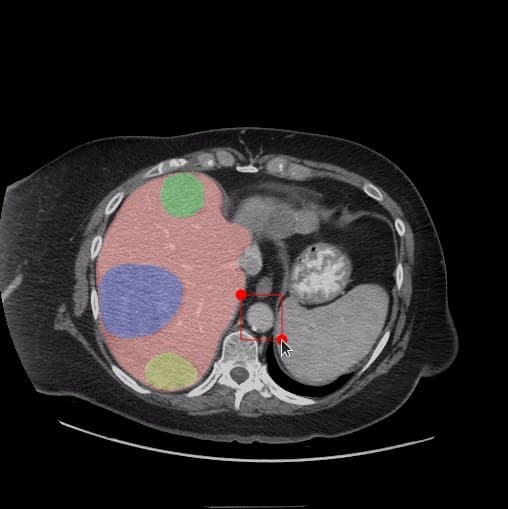
对完成脱敏的 CT、MRI、超声与内镜科研或教学数据集做批处理,计算器官体积、病灶区域、边界与跨期变化。结果仅用于研究与测量,不作为诊断结论,也不宣称是通过临床认证的医疗器械输出。
输出示例 · 医疗影像
在 CT 切片上勾出权重支持的器官与目标区域,并保留体素几何,因此体积与边界可以被测量。属于科研与测量处理,不构成诊断。
公开精度指标与类别体系
医疗侧用 Dice 而不是 IoU 计分。平均值会掩盖真正影响测量的部分:大器官基本已经做到位,小的或低对比度的结构还差好几个点;而当扫描设备和采集协议与权重训练时不同,这个差距还会继续拉大。
BTCV 腹部 CT · 平均 Dice
- Swin UNETRCVPR'2291.8
- UNETRCVPR'2289.1
- nnU-Net3D full-res88.8
- PaNN85.4
- CoTr84.4
- TransUNet83.8
- SETR-PUP79.7
Swin UNETR · 各器官 Dice
- 肝98.5
- 脾97.6
- 右肾95.8
- 左肾95.6
- 胃95.3
- 主动脉94.8
- 下腔静脉90.4
- 门静脉与脾静脉89.9
- 胰腺89.7
- 胆囊89.3
- 食管87.5
- 肾上腺84.6
| 数据集 | 目标数 | 标注覆盖范围 |
|---|---|---|
| BTCV | 13 个器官 | 脾、右肾、左肾、胆囊、食管、肝、胃、主动脉、下腔静脉、门静脉与脾静脉、胰腺、左右肾上腺——增强腹部 CT。 |
| Medical Segmentation Decathlon | 10 个任务 | 脑肿瘤、心脏、肝与肝肿瘤、海马、前列腺、肺结节、胰腺与肿瘤、肝血管与肿瘤、脾、结肠癌——覆盖 CT 与多序列 MRI。 |
| BraTS | 3 个子区 | 全肿瘤、肿瘤核心、增强肿瘤,由 T1、T1ce、T2、FLAIR 四个配准后的 MRI 序列推出。 |
| KiTS | 2–3 类 | 肾与肾肿瘤;KiTS21 起把肾囊肿单列为一类。 |
| LiTS | 2 类 | 增强 CT 上的肝与肝肿瘤,病灶尺寸差异极大。 |
| AMOS | 15 个器官 | 腹部多器官,同时提供 CT 与 MRI,来自多个中心与多种设备——最接近真实混源临床影像库的公开数据。 |
工业语义分割
可用模型
Anomalib 中成熟的 PatchCore、PaDiM、EfficientAD、FastFlow 与 Reverse Distillation,用于异常定位;如果某种已知缺陷已有公开或客户提供的成熟权重,也可使用 U-Net、DeepLabv3+ 或 SegFormer。
数据集与缺陷类型
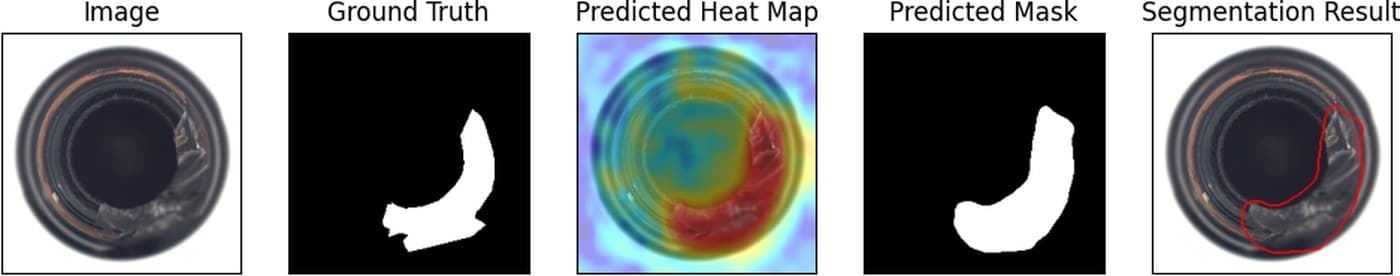
MVTec AD、VisA、BTAD 与 KolektorSDD 涵盖金属、织物、瓷砖、电缆、胶囊、瓶体、晶体管与电路板等表面和产品,可输出划痕、裂纹、污染、缺件与表面异常的热力图和掩膜。
适用范围与边界
适合机位、光照、尺度与产品外观相对稳定的重复检测影像。成熟权重匹配时,可测量缺陷面积、长度、形状并按阈值判定;生产场景变化很大或缺陷类别全新时通常需要模型研发,不属于本服务。
输出示例 · 工业表面与缺陷
同一处缺陷的输入图、真值、预测热力图、预测掩膜与最终结果。热力图只能让人看见缺陷,掩膜才让缺陷面积、长度与公差可以被测量。
公开精度指标与类别体系
异常检测按 AUROC 而不是 mIoU 计分,而图像级的数字已经全部在 97.9 以上——也就是说它已经区分不出方法优劣了。真正能预测热力图是否紧到可以据此量缺陷的,是像素级 AUROC 和 PRO 指标,所以两个我们都列出来。
MVTec AD · 图像级 AUROC
- PatchCoreensemble · CVPR'2299.6
- RD++CVPR'2399.4
- FastFlowWR5099.4
- EfficientAD-MWACV'2499.1
- EfficientAD-SWACV'2498.8
- Reverse DistillationWR5098.5
- PaDiMEfficientNet-B597.9
MVTec AD · 像素级 AUROC
- FastFlowWR5098.5
- RD++PRO 95.098.3
- PatchCorePRO 93.598.1
- Reverse DistillationPRO 93.997.8
- PaDiMPRO 92.197.5
| 数据集 | 类别数 | 数据覆盖范围 |
|---|---|---|
| MVTec AD | 15 个类别 · 73 种缺陷 | 5 类纹理(地毯、网格、皮革、瓷砖、木材)与 10 类物体(瓶、电缆、胶囊、榛子、金属螺母、药片、螺丝、牙刷、晶体管、拉链);共 5,354 张图,缺陷带像素级标注。 |
| VisA | 12 类物体 | PCB1–4、胶囊、腰果、口香糖、Fryum、通心粉 1–2、蜡烛、管状 Fryum;共 10,821 张图(9,621 正常、1,200 异常),含单图多实例场景。 |
| MVTec LOCO | 5 个类别 | 早餐盒、果汁瓶、图钉、螺丝袋、接线端子——除结构异常外还覆盖逻辑异常(数量不符、错件、错位)。 |
| BTAD | 3 类产品 | 2,540 张真实产线零件影像;表面与形貌缺陷在产线上拍摄,而非实验室环境。 |
| KolektorSDD / SDD2 | 表面裂纹 | 电子换向器与产线表面缺陷,带像素级裂纹标注——最接近固定工位检测场景的公开数据。 |
以上数字全部取自对应方法的官方论文或官方模型库,不是我们自己的评测结果。各行的骨干网络、输入分辨率、单尺度与多尺度测试口径并不一致,且每张图的横轴都按说明做了截断——请把它们当作量级参考,而不是精确到零点几分的排名。另外,权重在自己基准上的分数同时也是上限:换到你的影像、你的类别上,实际只会更低。所以每个项目都从样本试跑开始,我们对外承诺的是那次实测结果,而不是这里的公开指标。来源:SegFormer(NeurIPS 2021)、DeepLab 官方模型库、HRNet、Mask2Former(CVPR 2022)、OneFormer、PP-LiteSeg / PaddleSeg、Swin Transformer、LoveDA(NeurIPS 2021 D&B)、GeoSeg、Swin UNETR(CVPR 2022)、PatchCore(CVPR 2022)、FastFlow、EfficientAD(WACV 2024)、RD++(CVPR 2023)、PaDiM。
示例影像来自开源项目,并按其许可证使用:MMSegmentation 与 Anomalib(Apache-2.0)、MedSAM(Apache-2.0)、GeoSeg(GPL-3.0)。此处用于说明每类输出的形态,实际项目在你的影像上运行。
服务范围
你实际拿到的是什么
掩膜只是中间产物。由它算出来的统计结果,以及证明这些结果可信的证据,才是交付物。
逐张掩膜
索引 PNG 或单波段 GeoTIFF,一个类别一个取值,分辨率与源影像一致。
类别配色表
调色板与类别的对应关系以数据形式交付,掩膜在任何软件里打开配色都一致。
逐类统计
每张影像各类别的像素数、面积与占比;影像有地理参考或标定时,直接给到真实单位。
矢量多边形
掩膜转成多边形,简化容差由你指定,可直接进 GIS 与 CAD 流程。
实例对象
当问题是「有几个」而不是「占多少」时,把连通区域逐个计数并测量。
置信度图层
逐像素置信度与掩膜一并输出,低置信区域可以复核,而不是盲目采信。
精度报告
对照人工打分样本给出总体与逐类的 IoU、精确率与召回率,样本本身也一并交付。
变化对比
有两期数据时,给出各类别的增减,并写明两期是如何配准比较的。
方法记录
所用权重名称与许可、原生类别表、输入转换、推理设置、阈值与后处理步骤,全部记录并标注版本。
处理清单
逐文件记录处理状态、输出路径、警告与失败原因,大批量任务可审计、可断点续跑。
交付格式
按你的技术栈习惯的方式交付
- PNG / TIFF 掩膜
- 索引掩膜,另可附带上色叠加图,便于复核与写报告。
- GeoTIFF
- 与源影像配准的带地理参考掩膜,可直接在 QGIS 与 ArcGIS 中使用。
- GeoJSON / Shapefile
- 矢量化后的类别图层,每个多边形带面积与类别属性。
- NIfTI / DICOM 派生掩膜
- 用于医疗科研流程的逐层或三维重建掩膜,保留源文件标识与空间对应关系。
- CSV / Excel
- 逐张与汇总的类别统计,精度报告单独成表。
- JSON 处理清单
- 逐文件记录输入输出映射、模型版本、类别体系、处理状态与异常说明。
样例数据
你实际拿到的是什么
示例项目数据。行人、灯杆这类细小类别的得分,永远低于大面积连续类别;把它们单独列出来正是重点所在——一个平均值恰好会盖住最可能出错的那几类。
| 类别 | 像素占比 % | IoU | 精确率 | 召回率 | 样本数 |
|---|---|---|---|---|---|
| 路面 | 31.4 | 0.94 | 0.96 | 0.97 | 480 |
| 建筑 | 24.8 | 0.91 | 0.93 | 0.95 | 480 |
| 植被 | 18.2 | 0.89 | 0.92 | 0.94 | 480 |
| 天空 | 12.6 | 0.97 | 0.98 | 0.99 | 480 |
| 车辆 | 7.1 | 0.83 | 0.88 | 0.90 | 480 |
| 行人 | 1.4 | 0.68 | 0.79 | 0.76 | 480 |
服务流程
五个步骤,每个项目都一样
- 步骤 01
提供代表性样本
我们先检查影像类型、分辨率、波段或医疗模态、目标类别、数据量,以及结果要支撑的测量。
- 步骤 02
核对成熟权重
把需求与公开成熟模型或客户已有模型匹配,确认现有类别表是否覆盖所需输出。
- 步骤 03
先跑一批样本
先推理并复核一组代表性文件;领域不匹配或必须训练时,在全量处理和报价前明确停止。
- 步骤 04
批量处理全量数据
统一整理文件,用固定权重批量推理并后处理,所有输入输出写入可断点续跑的处理清单。
- 步骤 05
验证并交付结果
抽样检查后,交付掩膜、统计、矢量或三维体积、置信度与异常记录,以及完整方法说明。
项目按文件数量与大小、影像类型、预处理和切片要求、所选成熟权重、输出格式与验证深度定价,不包含训练、微调与新类别标注。请先提供代表性样本和所需类别;确认现有模型匹配后,我们再给出固定的批量推理报价。
常见问题
客户经常问到的问题
什么是语义分割?
语义分割是把图像中的每一个像素都归到某个类别。相比之下,分类是给整张图打一个标签,检测是给目标画一个框。当答案是一个面积或一个形状时——这个场景里植被占多少、这处缺陷范围有多大——分割才是对的工具,而不是一个「是」或「否」。
能处理哪些影像?
街景与 360 全景、无人机与航空摄影、卫星瓦片、工业检测图像、视频帧,以及 CT、MRI、超声与内镜等医学影像。实际的限制只有两条:分辨率相对于你最关心的那个最小类别够不够,以及这些类别在你手上的影像里到底看不看得见。
你们会帮我们训练或微调模型吗?
不会。这项服务只使用成熟预训练权重或客户提供的现有权重,代跑客户的数据集;不包括采集训练标注、从零训练或为新类别做微调。通常不需要客户提供训练标注,但影像领域与目标类别必须已经被某个成熟权重支持。我们会先用代表性样本核实,再报价全量处理。
精度有多高?
取决于类别,所以我们按类别报告,而不是给一个总的漂亮数字。道路、建筑、天空这类大面积连续类别,IoU 通常能到 0.90 以上;行人、灯杆、电线这类细小类别会明显更低。每个项目都会对照人工打分样本做验证,样本本身也随结果交付,让你可以自己复核这个说法。
如果没有现成模型适合我们的数据怎么办?
那就不会硬套模型。我们会说明具体不匹配在哪里——类别不支持、传感器或模态偏移、分辨率、采集条件或许可证限制——并建议另行寻找模型研发服务。训练与微调不在本项服务范围内。
可以处理视频而不是静态图吗?
可以。视频会按适合该问题的间隔抽帧,逐帧分割,并可在时间维度上做平滑,避免某个类别在相邻帧之间闪烁。结果可以按帧、按秒,也可以整段汇总来报告。
下一步
有具体的数据需求?
告诉我们语义分割需要覆盖哪片地域、包含哪些字段、多久刷新一次。正式开工前,你会先拿到明确方案、样例数据与固定报价。