概述
POI 数据集的上限,由它的类别体系决定
兴趣点看上去很简单:一个名称、一组坐标、一个类别。真正的难点在一致性。同一家店,A 源标成「咖啡馆」,B 源标成「咖啡店」,C 源干脆归进「餐厅」。如果直接按原始标签计数,你的市场规模会因为信了哪一个标签而相差三分之一。
我们会把类别归并到一套经得起追问的体系里,同时把原始来源标签保留在单独一列,并把映射规则完整写下来。没有任何一条记录会被悄悄改类。
去重同样如此。同一家店出现在两个来源时,我们用名称归一化加距离阈值来判定,合并规则是写在文档里的,而不是埋在某段脚本中。
真实产出
一份真实数据的成图与度量
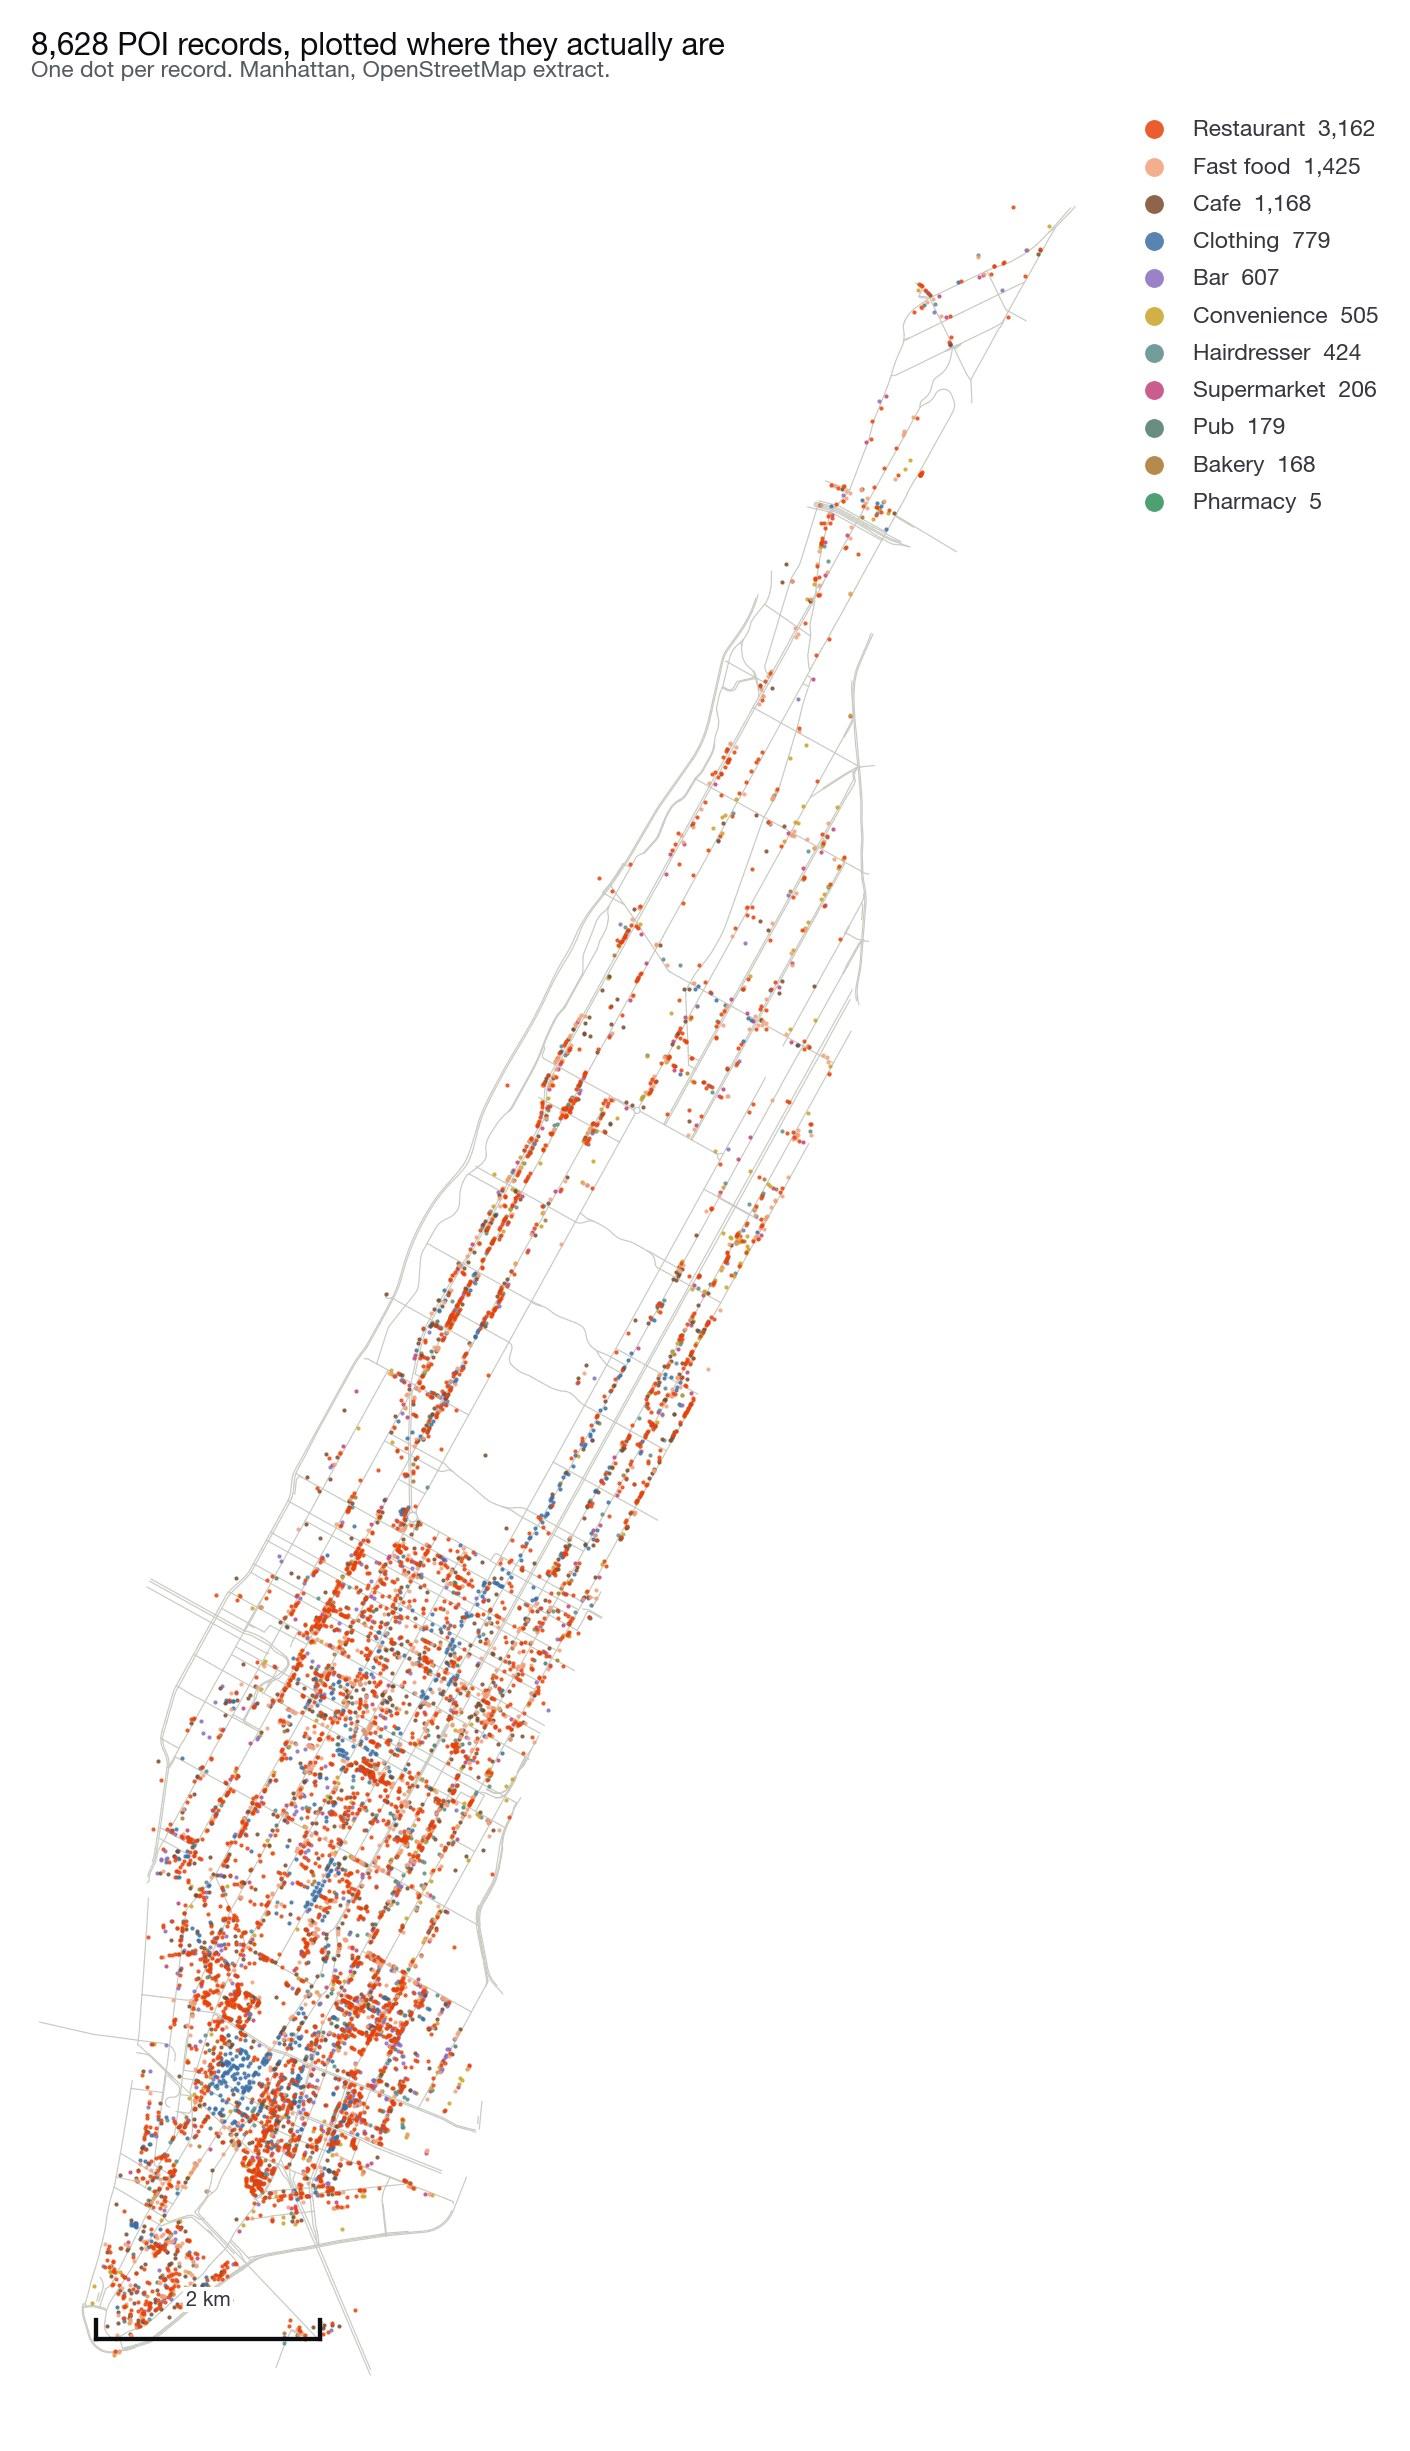
曼哈顿全域 8,628 条 POI 记录,取自一次 OpenStreetMap 数据提取,并按交付数据集同样的步骤跑了一遍。重点不在这张图好不好看,而在于下面每一句话都能拿数据核对。
每一条记录,都落在它真实的位置上
一条记录一个点,按类别着色,底图是真实路网。把全量数据而不是抽样画出来,是检验一份 POI 数据最直接的方式:缺漏、重复与坐标偏移,在这个尺度上全都藏不住。
同一份数据,放大到街道尺度
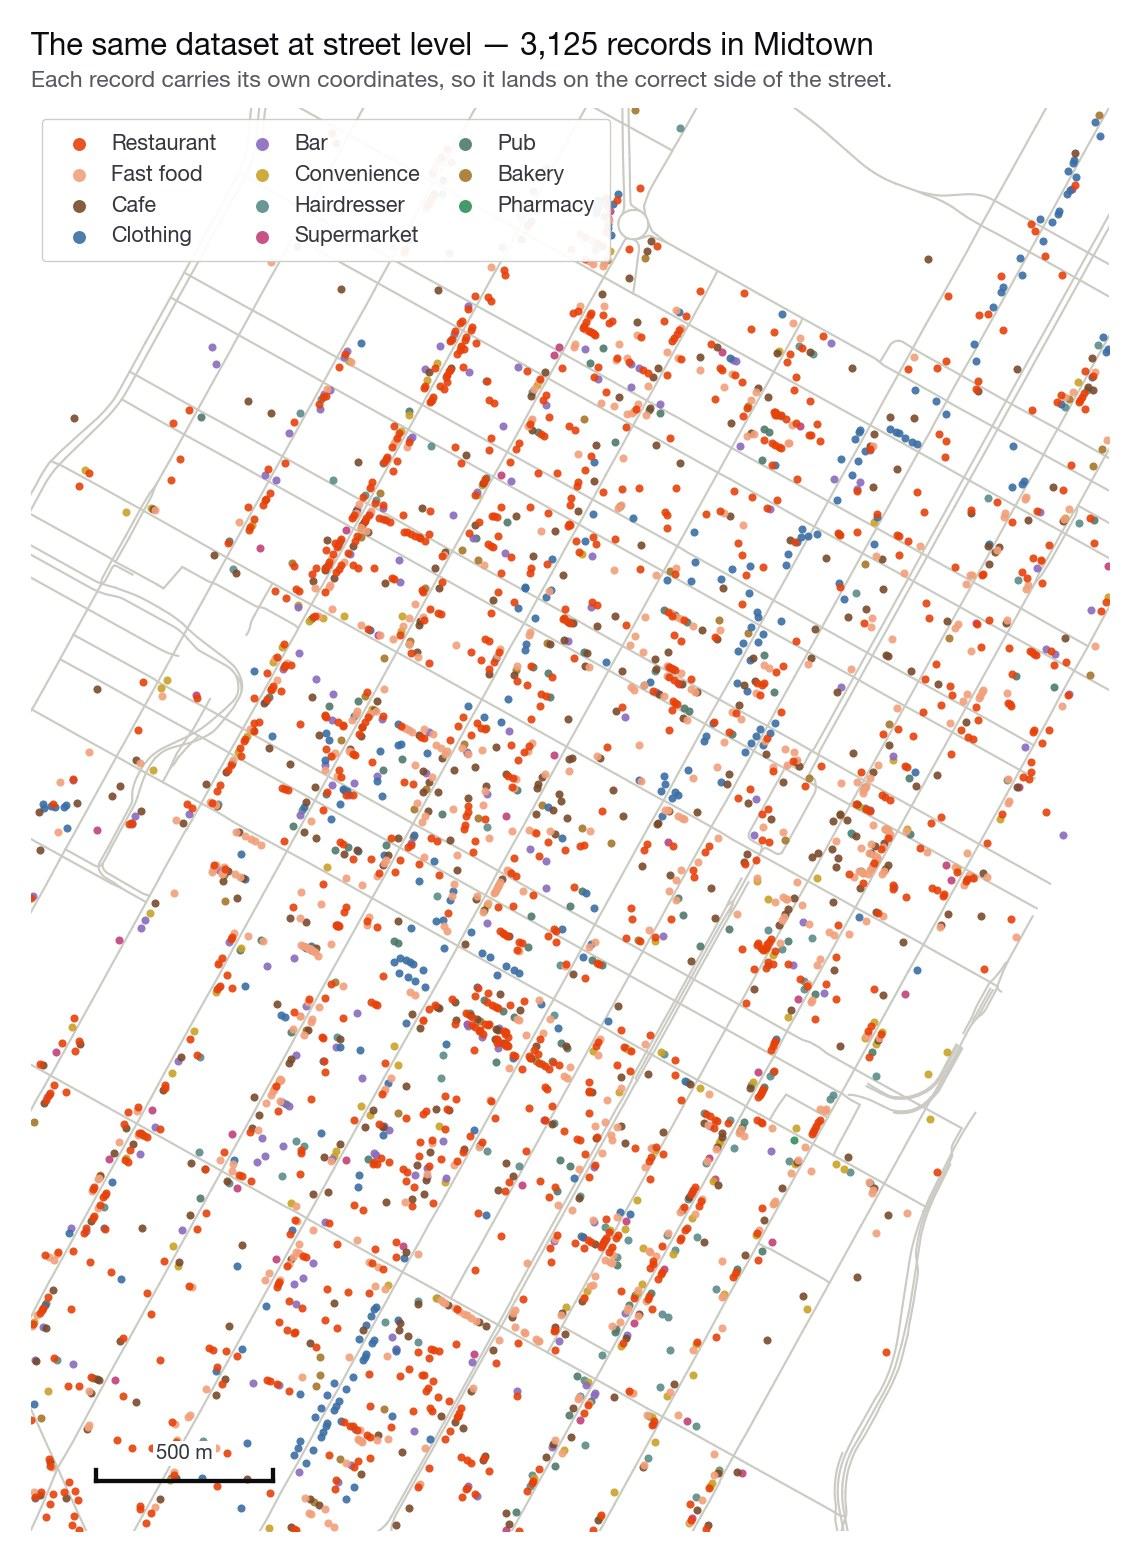
放大到中城,这里落着其中的 3,125 条记录。坐标精度足以让每条记录落在正确的那一侧街道上——后续的商圈分析与临街面分析,前提就是这个精度。
每个字段到底填充了多少
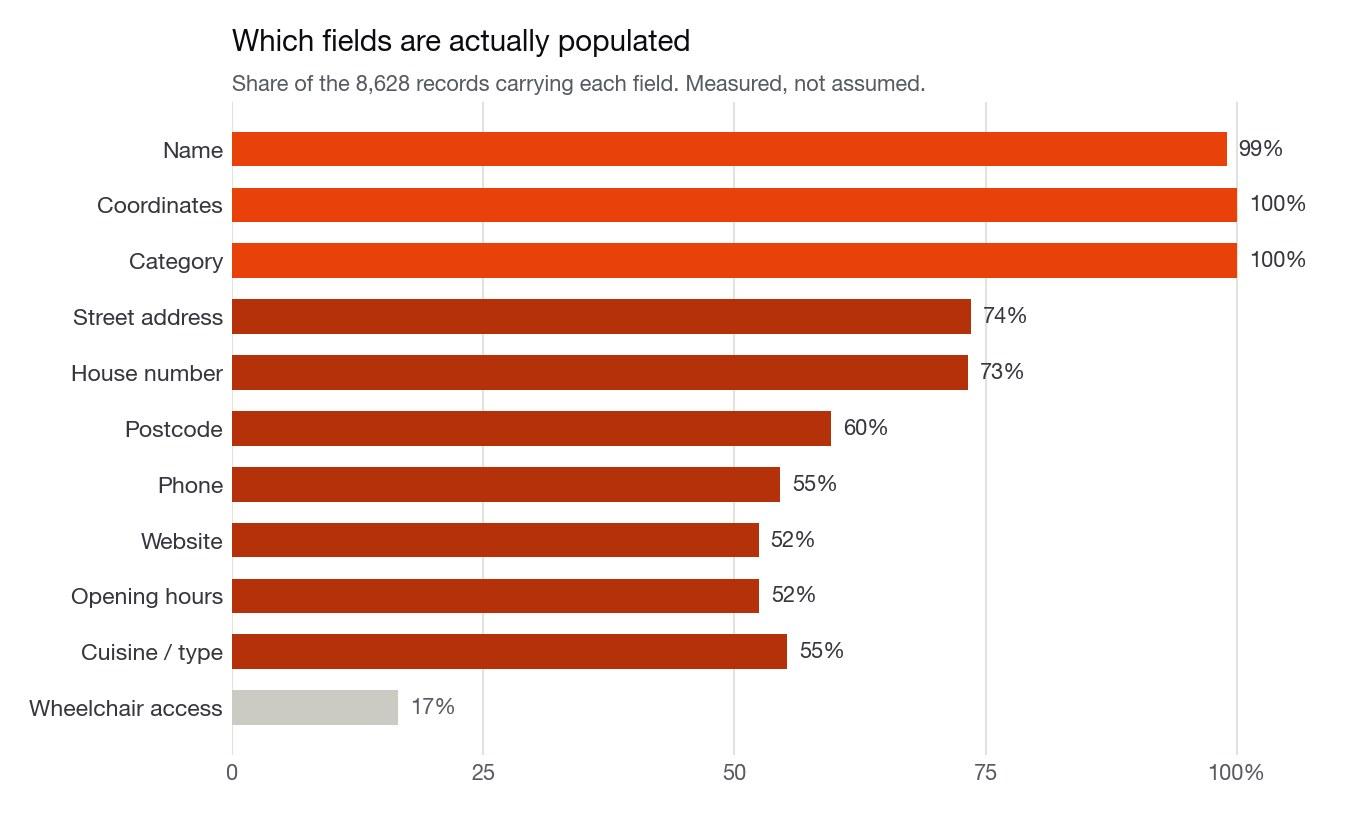
在全部 8,628 条记录上实测,而不是估计。名称、坐标与类别几乎满格;电话、网址与营业时间在五成上下。每个项目我们都会给出这张表,让你在动手用它之前就知道哪些字段撑得住。
数据来源 © OpenStreetMap 贡献者,遵循开放数据库许可(ODbL)。这里用公开数据是为了能公开展示;客户项目则运行在该项目约定的数据源上。
服务范围
一条 POI 记录包含什么
以下是标准字段。只要来源有公开,还可以按需增加属性字段。
POI 标识符
跨批次稳定的主键,便于长期追踪同一家门店的变化。
名称
对外公布的名称,另附一个用于匹配的归一化名称。
标准化类别
映射到约定好的类别体系,并在旁边保留原始来源标签。
坐标
WGS 84 下的经纬度,并与地址做过一致性校验。
地址成分
街道、城市、省/州、邮编与国家分列存储,而不是塞在一个字符串里。
联系方式
商户自行公开的电话与网址。
营业时间
结构化的每周营业时间,含季节性调整与休息日处理。
热度信号
来源公开的评分与评价数量,可作为需求强度的代理指标。
经营状态
营业中、暂停营业或已永久关闭,保证计数不虚高。
品牌与连锁标记
是否属于连锁品牌、属于哪一个,用于竞争格局分析。
行政区划关联
预先关联好的街道、邮编区或自定义分区标识,便于直接聚合。
采集时间
记录的采集时点,数据新鲜度不留疑问。
交付格式
按你的技术栈习惯的方式交付
- CSV
- 一行一个 POI,坐标以十进制度数表示。
- Excel
- 含数据表、类别映射表与覆盖率表的工作簿。
- JSON
- 嵌套结构,完整保留营业时间、类别与属性数组。
- GeoJSON
- EPSG:4326 点要素,可直接用于网页地图与 GIS 软件。
- Shapefile
- 带投影信息的点图层,适配 ArcGIS 工作流。
样例数据
你实际拿到的是什么
示例项目数据。来源标签始终保留在数据集中,任何一次类别判定都可以复查,也可以回退。
| POI 编号 | 名称 | 标准类别 | 来源标签 | 纬度 | 经度 | 状态 |
|---|---|---|---|---|---|---|
| POI-8841021 | Kirkwood Coffee | 咖啡馆 | Coffee shop | 33.75121 | -84.31688 | 营业中 |
| POI-8841022 | Grant Park Grocers | 食品零售 | Supermarket | 33.73894 | -84.36002 | 营业中 |
| POI-8841023 | Edgewood Pizza Co. | 餐厅 · 披萨 | Pizza restaurant | 33.75630 | -84.34199 | 营业中 |
| POI-8841024 | Old Fourth Ward Gym | 健身 | Gym | 33.76412 | -84.36871 | 暂停营业 |
| POI-8841025 | Inman Park Bakery | 烘焙 | Bakery | 33.76187 | -84.35364 | 营业中 |
| POI-8841026 | Reynoldstown Bar | 酒吧 | Cocktail bar | 33.75208 | -84.34617 | 营业中 |
服务流程
五个步骤,每个项目都一样
- 步骤 01
说明你需要什么数据
涉及哪些品类、哪片地域,以及这些计数最终要拿来做什么。
- 步骤 02
我们确定数据范围
共同敲定类别体系、字段清单,以及连锁门店与重复记录的处理方式。
- 步骤 03
我们采集并处理数据
采集来源数据,解析地址、校验坐标、完成类别映射。
- 步骤 04
我们校验数据集
对重复率、类别覆盖度与空间分布逐项核对,确认符合预期。
- 步骤 05
我们交付最终成果
POI 图层,附类别映射表、覆盖率汇总与采集时间说明。
按数据量、品类与城市数量报价;如果需要周期性刷新,还要看刷新频率。把覆盖范围告诉我们,你会拿到一份对应书面工作范围的固定报价。
常见问题
客户经常问到的问题
什么是 POI 数据?
POI 即兴趣点(point of interest),指以坐标形式记录、并带有属性的具体地点,比如餐厅、药店、ATM、学校或公交站。落到实处,一份 POI 数据集就是一张地点清单,包含名称、类别、位置,以及来源所公开的各类属性。
一座城市能采集到多少 POI?
取决于品类范围。中等规模城市的单一品类通常是几千条;大型城市的多品类全面采集则会达到数万条。正式开跑之前,我们会先做一个试点区域,给出数量预估。
重复的门店如何处理?
按一套写明的规则处理:先对名称做归一化,再把距离阈值内的候选记录在地址与类别上做比对。合并时保留信息最完整的一条,同时保留其他来源的标识符,不丢任何线索。
可以使用我们自己的类别体系吗?
可以。你提供分类标准,我们就按它映射,并交付映射对照表,让每一次归类判断都可复查。如果你还没有现成体系,我们会根据你打算如何聚合数据来提出一套建议方案。
数据有多新?
每条记录都带采集时间。一次性交付的数据,新鲜度就是该次运行的时点;对于需要持续监测的品类,可按周或按月刷新,及时反映关店等状态变化,每次运行都附变更日志。
能为我们已有的 POI 补充属性吗?
可以。把你的清单连同你使用的标识符一并发来,我们会补上坐标、类别、商圈属性或行政区划关联后返还,并完整保留你原有的主键。
下一步
有具体的数据需求?
告诉我们POI 数据需要覆盖哪片地域、包含哪些字段、多久刷新一次。正式开工前,你会先拿到明确方案、样例数据与固定报价。